قاموس مشفّر LZW يتقدم دائماً بإدخال واحد على وحدة فك الترميز التي ستقرأ مخرجاته، لذا لا يمكن للجانبين مشاركة عتبة واحدة لعرض الكود. تمنح PDFlibPas TPLLZWEncoder و TPDFLZWDecompressor عتبتين منفصلتين مشتقتين من نفس علم EarlyChange، وهذا التقدم بإدخال واحد هو السبب الكامل لوجود العلم أصلاً
تقريباً كل تطبيق LZW مكتوب يدوياً يخطئ في نفس المكان. تكتب وحدة فك الترميز أولاً، لأنها ما تحتاجه لفتح الملفات. تعمل. ثم تكتب المشفّر، مطابقاً منطق وحدة فك الترميز سطراً بسطر لأن LZW متماثل، وتشغّل اختبار ذهاب وعودة، فينجح. تشحن. بعد ستة أشهر يفتح عميل مخرجاتك في عارض ليس عارضك، فتجد قمامة من مكان ما في منتصف التدفق فصاعداً. كانت المرآة هي العلة: نصفا LZW ليسا متماثلين، والتظاهر بأنهما كذلك ينتج تدفقات لا يستطيع قراءتها إلا كودك أنت
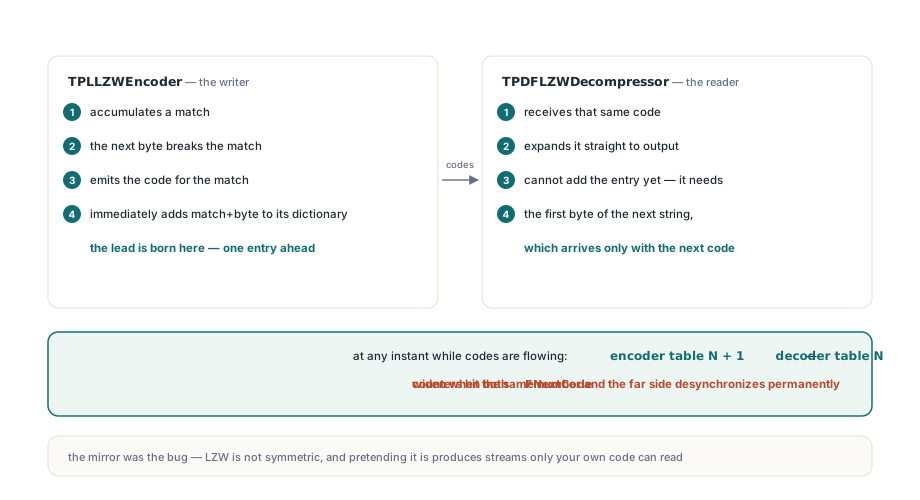
لماذا يحتاج المشفّر عتبة مختلفة عن وحدة فك الترميز؟
لأن المشفّر يتعلم كل إدخال قاموس قبل وحدة فك الترميز بخطوة واحدة. هذا ليس خيار تصميم في PDFlibPas؛ إنه متأصل في طريقة عمل LZW، وكل تنفيذ صحيح عليه التعويض عنه في مكان ما. سر في الحلقة وسترى من أين يأتي التقدم. يجمع المشفّر تطابقاً، فيجد أن البايت التالي يكسر المطابقة، فيصدر رمز المطابقة ويضيف فوراً المطابقة زائد البايت إلى قاموسه. تستقبل وحدة فك الترميز نفس الرمز وتوسّعه، لكنها لا تستطيع إضافة الإدخال المقابل بعد، لأن الإدخال الجديد يحتاج إلى أول بايت من السلسلة التالية، الذي لا يصل إلا مع الكود التالي. لذا في أي لحظة تتدفق فيها الرموز، يحمل جدول المشفّر إدخالاً أكثر من جدول وحدة فك الترميز. إذا وسّع الجانبان الكود من 9 إلى 10 بتات عندما يصل FNextCode الخاص بكل منهما إلى نفس الرقم، فإنهما يتسعان على بُعد كود واحد ويُفقد قارئ البتات في الطرف البعيد التزامنه نهائياً. في TPDFLZWDecompressor.ResetDictionary تُحسب عتبة وحدة فك الترميز مرة واحدة وتُخزن في FChangeCode:
// TPDFLZWDecompressor.ResetDictionary: جانب وحدة فك الترميز من العتبة
FCodeSize := FInitialCodeSize;                 // 9 بت لـ PDF LZWDecode
FBitMask  := (Cardinal(1) shl FCodeSize) - 1;  // 511
if FEarlyChange then
  FChangeCode := FBitMask                      // يتسع العرض عندما يصل FNextCode إلى 511
else
  FChangeCode := FBitMask + 1;                 // يتسع العرض عندما يصل FNextCode إلى 512
FClearCode := 1 shl (FCodeSize - 1);           // 256
FEOICode   := FClearCode + 1;                  // 257
FNextCode  := FClearCode + 2;                  // 258
حلقة فك الترميز توسّع العرض مباشرة بعد إلحاق إدخال، مختبرة (FNextCode = FChangeCode) and (FCodeSize < 12) ومعيدة حساب كل من FBitMask و FChangeCode للعرض الجديد. تتعثر تسع بتات عند 511 أو 512، وعشر بتات عند 1023 أو 1024، وإحدى عشرة بتة عند 2047 أو 2048، واثنتا عشرة بتة هي السقف حيث يجب مسح القاموس بـ ClearCode بدلاً من تنميته. لا يستطيع المشفّر إعادة استخدام أي من تلك الأرقام. يضيف GrowCodeSize واحداً للتعويض عن التقدم، لذا مع ضبط EarlyChange يتسع عند 512 بينما تتسع وحدة فك الترميز عند 511:
procedure GrowCodeSize(FinalDataCode: Boolean);
var
  ChangeCode: Cardinal;
begin
  if FCodeSize >= 12 then
    Exit;
  if FEarlyChange then
    ChangeCode := Cardinal(1) shl FCodeSize          // 512 while at 9 bits
  else
    ChangeCode := (Cardinal(1) shl FCodeSize) + 1;   // 513 while at 9 bits
  // يضيف مفكك الترميز آخر إدخال معلق لديه قبل أن يقرأ EOI.
  if FinalDataCode then
    Dec(ChangeCode);
  if FNextCode = ChangeCode then
    Inc(FCodeSize);
  end;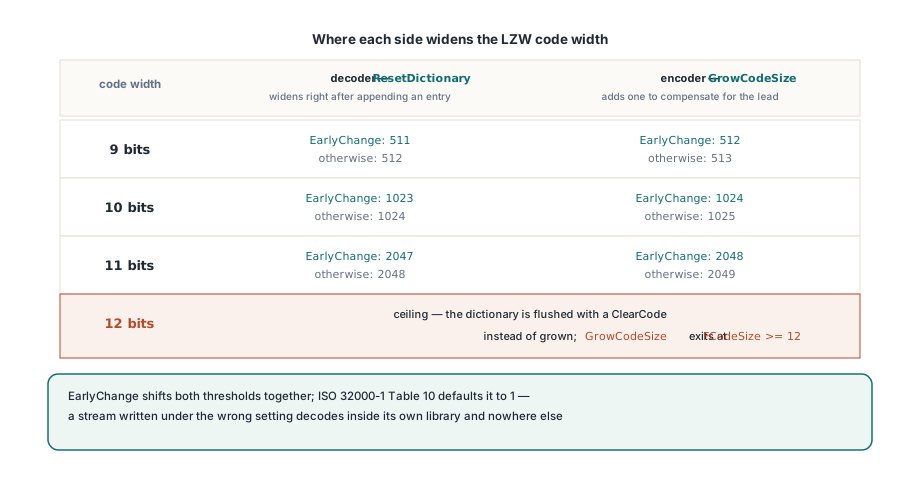
رمز البيانات الأخير هو المكان الذي يلتقي فيه الجانبان أخيراً
نهاية التدفق هي المكان الوحيد الذي يجب على المشفّر فيه التوقف عن التقدم والتفكير كوحدة فك ترميز، وهذا هو الغرض من معامل FinalDataCode في GrowCodeSize. أصدر رمز EOI بالعرض الخاطئ وكل ما قبله يبقى صالحاً تماماً، لذا يختبئ العيب خلف آلاف البايتات الصحيحة. التسلسل يجري هكذا. يصدر المشفّر رمز بياناته الأخير، وخلافاً لكل تكرار سابق لا يضيف شيئاً إلى قاموسه بعده، لأنه لا يتبقى بايت تالٍ ليمدد به المطابقة. تفعل وحدة فك الترميز العكس: تستقبل ذلك الرمز الأخير، والآن فقط يمكنها إكمال الإدخال الذي كانت تحمله منذ الرمز السابق. في الخطوة الأخيرة تلحق وحدة فك الترميز، ينهار التقدم إلى الصفر، والعرض الذي ستستخدمه لقراءة EOI يقرره إدخال لم ينشئه المشفّر أبداً. Dec(ChangeCode) هو المشفّر يتظاهر، لاستدعاء واحد فقط، بأنه وحدة فك ترميز:
// TPLLZWEncoder.Compress، ذيل الدفق
EmitCode(CurCode);      // رمز البيانات النهائي، بأي عرض حالي
GrowCodeSize(True);     // قد يتسع العرض باستخدام العتبة المنقوصة
EmitCode(FEOICode);     // EOI بالعرض الذي سيقرؤه مفكك الترميز فعليًا
FlushBits;
FlushOutput;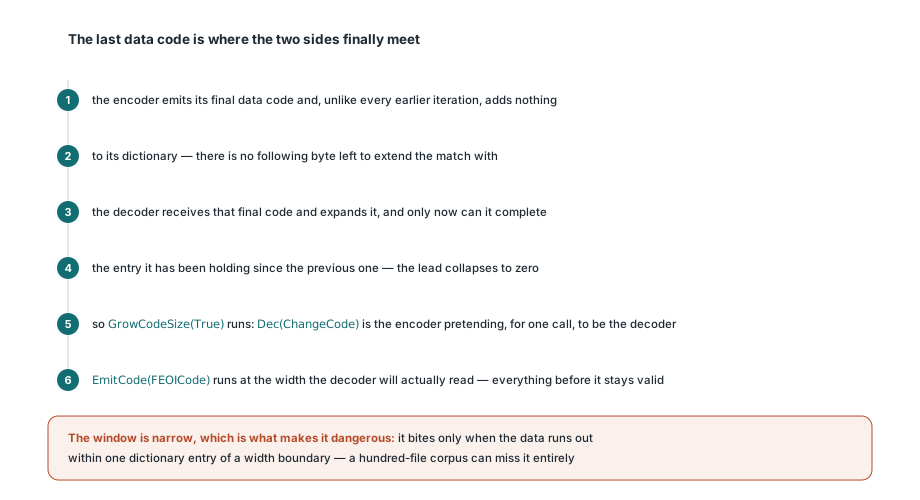
النافذة التي يهم فيها هذا ضيقة، وهذا ما يجعله خطيراً. يعض فقط عندما تصادف البيانات نفادها على بُعد إدخال قاموس واحد من حدود العرض، لذا قد تفوّته مجموعة مئة ملف اختبار بالكامل بينما يصيبه ملف عميل واحد في كل مرة. حالات الحدود في Compress يجب دفعها عمداً: اصنع مدخلات يهبط قاموسها عند 510 و 511 و 512 إدخالاً، ثم اقرأ عرض بتات EOI الصادرة من التدفق بيدك بدلاً من استنتاجه من فك ترميز ناجح
لماذا يمكن لاختبار ذهاب وعودة ناجح أن يخفي تدفقاً مكسوراً؟
لأن تنفيذين يرتكبان نفس الخطأ يتفقان مع بعضهما. إذا وسّع مشفّرك ووحدة فك الترميز لديك كلاهما كوداً مبكراً جداً، أو كلاهما متأخراً جداً، يبقيان بنفس الخطوة، ويعيد اختبار الذهاب والعودة إنتاج المدخلات بايتاً ببايت، وتكون المجموعة خضراء بينما التدفق الذي أنتجته غير قابل للقراءة بأي شيء آخر. هذا هو أثمن شيء يمكن اقتناؤه من التمرين كله: بالنسبة لـ LZW، الاتساق الذاتي بلا قيمة كدليل. لذا لا يمكن أن يكون اختبار الذهاب والعودة الذاتي الاختبار الأساسي، وتتحقق PDFlibPas من مسار LZW بثلاث طرق أخرى بدلاً من ذلك. تدفقات كود مبنية يدوياً بنمط البتات المتوقع مكتوباً يدوياً، بحيث يكون التأكيد حول البايتات لا حول نتيجة فك ترميزها. توافق تشغيلي ثنائي الاتجاه ضد تنفيذات مستقلة، حيث تُفك التدفقات التي أنتجها هذا المشفّر في مكان آخر، وتُفك التدفقات المنتجة في مكان آخر بواسطة TPDFLZWDecompressor. وفك ترميز تفاضلي، بقراءة نفس البايتات مرتين مع ضبط EarlyChange في الاتجاهين، بحيث يخبرك التدفق الذي يُفك بنظافة تحت الإعداد الخاطئ أن حدود العرض لم تُمرّن أصلاً:
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := True;
  A := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := False;   // القاعدة الخاطئة عمدًا بالنسبة لـ PDF
  B := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
// يجب أن يطابق A المصدر؛ ويجب ألا يطابقه B. إذا طابقه B أيضًا،
// كان الإدخال قصيرًا جدًا لعبور حد عرض الكود.
المدخلات الخارجية هي ما يمنح هذه التغطية فعلاً. مادة الاختبار الحالية تعبر عروض 9 و 10 و 11 و 12 بتة وترغم 34 إعادة تعيين قاموس في تدفق واحد، وهي الطريقة الواقعية الوحيدة لإثبات أن مسار ClearCode عند سقف 4095 يعمل أصلاً. إذا لم تتجاوز بياناتك الاختبارية بضعة كيلوبايتات أبداً، فلن يعمل أي من ذلك الكود. وعندما يغيّر إصلاح ما ينتجه مشفّرك، عامل المخرجات القديمة كشيء مكسور لا كخط أساس توافق يستحق الحفظ؛ التدفق الذي يخلط عروض الكود بشكل خاطئ ليس صيغة قديمة، إنه عيب صادف أن كُتب على القرص
PDF تقول 1، و TIFF تقول حسب السياق
تجعل PDFlibPas قيمة EarlyChange الافتراضية True على كل من TPLLZWEncoder و TPDFLZWDecompressor لأن جدول 10 في ISO 32000-1 يعرّف EarlyChange كمعامل فك ترميز LZWDecode بقيمة افتراضية 1، أي أن طول الكود يزداد كوداً واحداً مبكراً. هذا محدد في القسم 7.4.4.2 من ISO 32000-1 إلى جانب معاملات المتنبئ، وملف PDF يريد السلوك الآخر عليه أن يقول /EarlyChange 0 صراحة في قاموس /DecodeParms الخاص به. TIFF هي سبب كون العلم خاصية لا ثابتاً: يصف القسم 13 من TIFF 6.0 ضغط LZW دون نفس العبارة غير الملتبسة، والمشفّرات المنتشرة في البرية انقسمت تاريخياً عليه، وهذا على الأرجح سبب شعور مواصفة PDF بالحاجة إلى تسمية المعامل أصلاً. على خط أنابيب TIFF إلى PDF، إذن، الإعداد ليس شيئاً يمكنك ترميزه ثابتاً في أي من الطرفين. ما تبيّن أن جانب TIFF يحتاجه يجب نقله صراحة إلى /DecodeParms في PDF، وإلا حوّلت ملفاً كان يُفتح بسلام إلى ملف لا يُفتح. العناية نفسها تنطبق على FillOrder، حيث يختار foTop و foBottom أي نهاية من البايت يملأ منها قارئ البتات، وعلى فرق TIFF Predictor 2 الأفقي الذي ينقله TPDFLZWParms عبر Predictor و Colors و BitsPerComponent و Columns. تغطي ملاحظاتنا عن تقوية وحدة فك ترميز TIFF المدمجة لـ BigTIFF والتخطيطات المبلطة بقية ذلك المسار
فخان أصغران يستحقان التسمية
كلاهما سهل الربط بشكل خاطئ عندما تفتح كائني المشفّر ووحدة فك الترميز جنباً إلى جنب وتفترض أن التماثل يصمد هناك أيضاً:
InitialCodeSizeلا يعني الشيء نفسه على الصفين.TPLLZWEncoder.InitialCodeSizeهو عرض رمز الجذر، ويُتحقق منه على أنه 2 حتى 8، مع اشتقاقInitDictionaryلـFClearCodeكـ1 shl FInitialCodeSizeوضبطFCodeSizeعلىFInitialCodeSize + 1. أماTPDFLZWDecompressor.InitialCodeSizeفهو أول عرض كود، ويُتحقق منه على أنه 2 حتى 9، مع اشتقاقResetDictionaryلـFClearCodeكـ1 shl (FCodeSize - 1). لبيانات PDF العادية ذات 8 بتات يكون الافتراضيان 8 و 9 على التوالي ولا تلاحظ ذلك أبداً؛ اضبطهما يدوياً على نفس الرقم وستكون قد بنيت زوجاً غير متطابق- فك ترميز LZW غير الموثوق به مشكلة سلامة ذاكرة قبل أن يكون مشكلة صحة، لأن فهارس القاموس تأتي مباشرة من الملف. يرفض
TPDFLZWDecompressorأي كود فوق 4095 أو عند أو فوقFNextCode، ويرفض إضافة إدخالات تتجاوز 4095، ويتحقق من المدخلات المتبقية بالبتات قبل كلGetNextCode، ويكشفSawExplicitEOIبحيث يستطيع المتصل تمييز التدفق المنتهي بشكل صحيح عن الذي نفدت بايتاته فحسب. التدفق المبتور ليس نجاحاً جزئياً. يغطي الاستطلاع الأوسع في تقوية محلل PDF مكتوب بـ Pascal ضد الملفات الخبيثة فئة العيوب التي تسدها هذه الحراسات
ما يتركك معه هذا
يبدو LZW متماثلاً وهو ليس كذلك. يتقدم قاموس المشفّر بإدخال واحد عبر جسم التدفق ويختفي التقدم عند الكود الأخير، لذا يحمل التنفيذ الصحيح عتبتين زائد حالة خاصة واحدة، ويحوّل علم EarlyChange العتبتين معاً. أخطئ في أي منهما بكود واحد وستنتج مخرجات صالحة حتى اللحظة التي لا تكون فيها صالحة، دون أي خطأ أو استثناء في أي مكان، فقط عارض ما يرسم ضجيجاً. الحدود الصادقة هي أن أياً من هذا غير قابل للاختبار من الداخل: لا شيء في مجموعتك الخاصة يستطيع تمييز التدفق الصحيح من الخاطئ باستمرار، لذا فحص التوافق ليس تمريرة إضافية اختيارية، بل هو الدليل الحقيقي الوحيد الذي ستحصل عليه. يشحن الصفان في PDF Library for Delphi، التي تتولى أيضاً عمل البنية المحيطة الموصوف في ملاحظاتنا عن تدفقات الكائنات وتدفقات المراجع المتقاطعة، لـ Delphi و C++Builder عبر إصدارات المترجم التي تدعمها المكتبة